INPUT
Neznámý zdroj
URL může vrátit RSS, Atom, JSON nebo dokonce HTML.
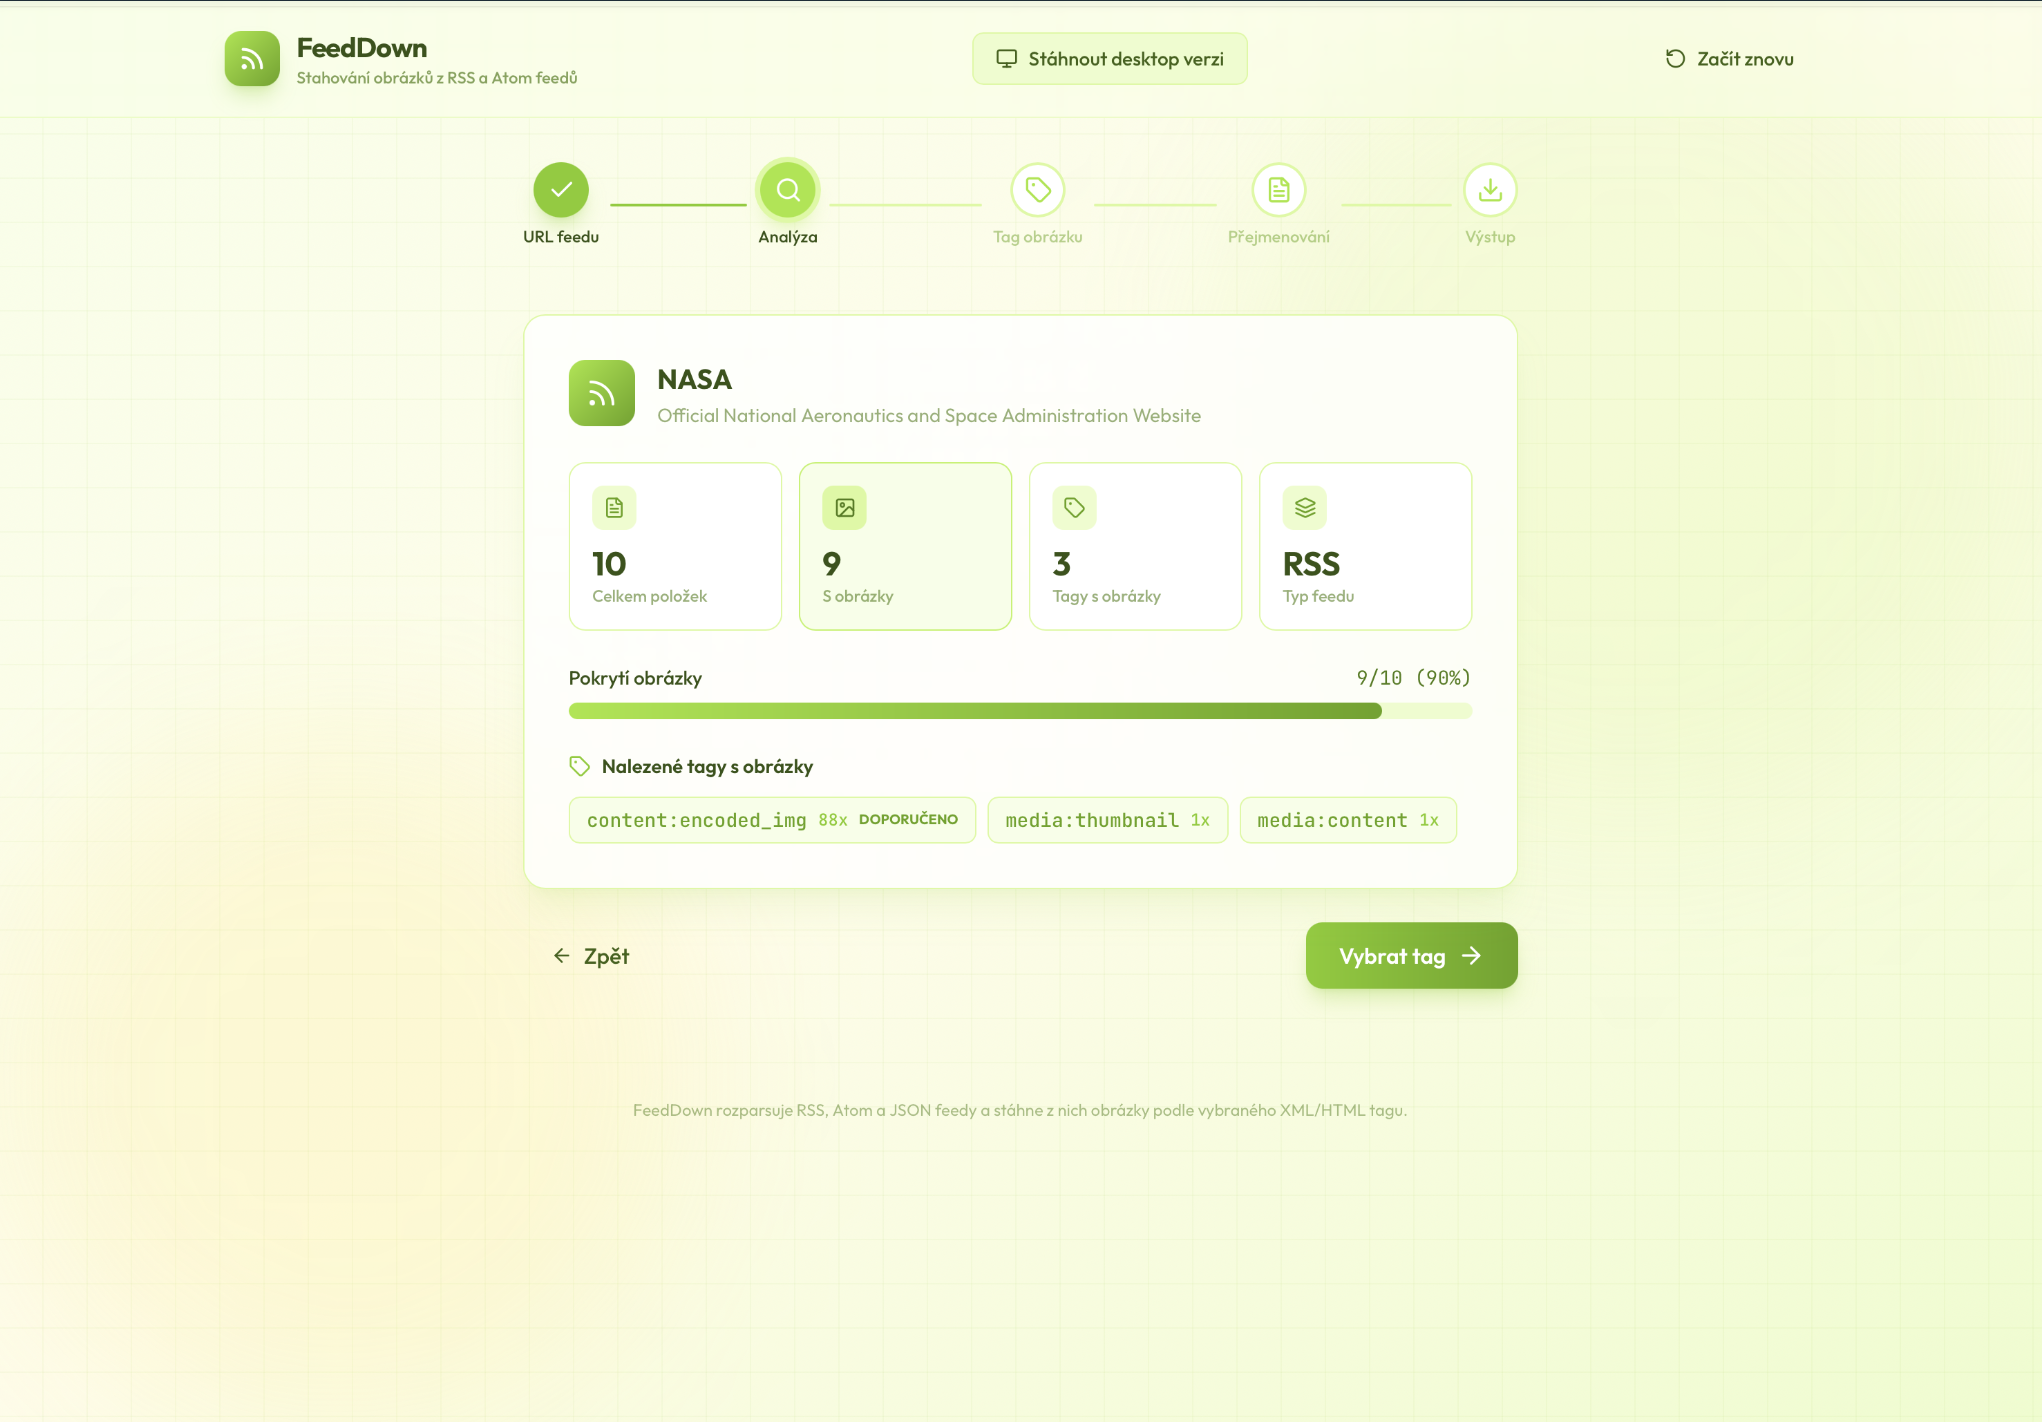
Menší web s jasným účelem. Firemním standardem pro sdílení obrázků e-shopů, jsou takzvané feedy. jejich stažení vyžaduje aby se člověk dostal na stránku feedu, našel adresu na obrázek, otevřel ji, dal uložit a soubor nějak pojmenoval. Ale z logiky věci, feedy nejsou tvořeny lidmi pro lidi. Jsou to skriptově generované stránky určené pro script, který je zvládne stáhnout. a přesně takový nástroj je tento web, web obsahuje i desktopovou aplikaci v pythonu pro stahování wětších feedů a automatické ukládání. aktuální vezme má některý prohlížečích se stahováním po jednom, prosím zvolte zip, na opravě se bude v budoucnu pracovat
Feedy nejsou jeden standard, spíš divoký západ. Obrázek může být v enclosure, media:content, media:thumbnail, content:encoded, v description nebo úplně jinde v JSON Feedu. FeedDown proto vstup nejdřív uklidí a normalizuje a až potom ho analyzuje.
Feedy nemají jednotný tvar, takže se vstup rozpadá na čtyři různé problémy. Každý z nich řeší jiná část appky.
URL může vrátit RSS, Atom, JSON nebo dokonce HTML.
Parser má oddělené větve pro RSS, Atom a JSON Feed.
Obrázky se hledají ve více standardních i vložených strukturách.
Výsledkem není jen náhled, ale strukturovaná data použitelná dál.
Appka proto nejdřív všechno sjednotí a až pak analyzuje. Jak ta cesta vypadá krok po kroku, ukazuje další schéma.
Rozdělení je záměrné. Síť řeší fetching, formát řeší parser a další vrstva už dostává čisté položky. Díky tomu se exportní logika nemusí trápit XML syntaxí.
export async function GET(request) {
  const { searchParams } = new URL(request.url);
  const feedUrl = searchParams.get("url");

  if (!feedUrl) {
    return Response.json({ error: "Chybí parametr url." }, { status: 400 });
  }

  let parsed;
  try {
    parsed = new URL(feedUrl);
    if (!parsed.protocol.startsWith("http")) {
      throw new Error("invalid protocol");
    }
  } catch {
    return Response.json({ error: "Neplatná URL feedu." }, { status: 400 });
  }

  const controller = new AbortController();
  const timeout = setTimeout(() => controller.abort(), 15000);

  try {
    const resp = await fetch(parsed.toString(), {
      signal: controller.signal,
      redirect: "follow",
      headers: {
        "User-Agent": "FeedDown/1.0 (+https://FeedDown.app)",
        Accept: "application/rss+xml, application/atom+xml, application/json, text/xml, application/xml, text/plain, */*",
      },
    });
export function parseFeed(content, contentType) {
  const trimmed = content.trim();

  if (trimmed.startsWith("{") || contentType.includes("application/json")) {
    try {
      const data = JSON.parse(trimmed);
      return parseJsonFeed(data);
    } catch {
      // fall through to XML
    }
  }

  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(content, "text/xml");

  const parserError = xmlDoc.querySelector("parsererror");
  if (parserError && !xmlDoc.querySelector("rss") && !xmlDoc.querySelector("feed")) {
    const htmlDoc = parser.parseFromString(content, "text/html");
    const rssLink = htmlDoc.querySelector('link[type="application/rss+xml"]');
    if (rssLink) {
      throw new Error(`Toto je HTML stránka, ne feed. RSS odkaz nalezen: ${rssLink.getAttribute("href")}`);
    }
    throw new Error("Feed se nepodařilo rozparsovat. Obsah není platný RSS, Atom ani JSON Feed.");
  }
export async function fetchAndAnalyzeFeed(feedUrl) {
  const proxiedUrl = `/api/feed-proxy?url=${encodeURIComponent(feedUrl)}`;

  const resp = await fetch(proxiedUrl);

  if (!resp.ok) {
    let message = `Feed se nepodařilo načíst (HTTP ${resp.status}). Zkuste jiný feed.`;
    try {
      const data = await resp.json();
      if (data?.error) message = data.error;
    } catch {
      // response wasn't JSON, keep default message
    }
    throw new Error(message);
  }

  const contentType = resp.headers.get("x-original-content-type") || "";
  const text = await resp.text();

  if (!text || text.trim().length === 0) {
    throw new Error("Feed je prázdný nebo se nepodařilo načíst obsah.");
  }

  const parsed = parseFeed(text, contentType);
  return analyzeFeed(parsed);
}
Nejtěžší nebyla syntaxe DOMParseru, ale množství variant pro tu samou věc. Jeden feed dá obrázek do atributu, druhý do HTML uvnitř description. Parser proto skládá jednotný seznam imageSources a u každého obrázku si pamatuje, odkud se vzal.
Stejná věc se v každém formátu zapisuje jinak. Tady je přehled variant, které parser musí umět přečíst.
Klasický feed s přílohami.
Namespace-based media data.
Jiný model položky a odkazu.
Struktura mimo XML.
Všechny větve končí ve stejném seznamu obrázků i s informací, odkud přišly. Exportu je pak jedno, z jakého formátu data původně jsou.
V repu je downloader a XLSX závislosti. To dává smysl až po normalizaci, protože exportu je jedno, jestli data původně přišla z RSS, nebo z JSONu.
FeedDown je skvělý příklad appky, kde frontend není hlavní problém. UI může být jednoduché, ale pod ním je pipeline, která musí přežít nepořádek na vstupu a přitom vrátit pořádek na výstupu.
Žádná technologie tu není jen pro parádu. Tady je rychlý přehled, kdo za co odpovídá.
Nejde mi jen o to, jak to vypadá. Baví mě hlavně to, co je pod tím: kudy data tečou, co se validuje, co může selhat a proč jsem to udělala právě takhle.
Napiš mi